Quando a leggere il negozio è l'intelligenza artificiale
Dalla 26.9 Maho si fa usare dagli agenti (server MCP, 201 strumenti, login OAuth) e si fa leggere da loro con robots.txt, llms.txt e markdown.
L’intelligenza artificiale arriva su un negozio da due direzioni opposte, e la 26.9 le copre tutte e due. Da una parte c’è un agente che opera: entra nel backend, guarda le giacenze, crea un’ordine, lavora per un cliente autenticato. Dall’altra c’è un assistente che legge e cita: risponde a una domanda su un prodotto e menziona il negozio, senza mai fare login. Sono due mestieri con permessi diversi, rischi diversi e manopole diverse, e in Maho hanno strumenti separati.
Un agente che entra e lavora
Il server MCP è la porta con cui un client capace di tool calling, quindi Claude, ChatGPT o un editor, parla con il backend. Si accende in System > Configuration > Services > API, perché è un protocollo come gli altri, e si spegne come gli altri.
L’accesso è pensato per una persona davanti a un browser: incolli l’URL del negozio nel client, l’agente ti porta al pannello, tu fai login e approvi la connessione. È OAuth 2.1 con login dal browser, quindi non ci sono chiavi da copiare in un file di configurazione e non resta un token nella cronologia della chat.
La parte che conta per la manutenzione è un’altra: gli strumenti non sono scritti a mano, sono derivati
dalla stessa metadati ApiResource che alimentano REST e GraphQL. Un’installazione standard espone 201
strumenti, da catalog_products_list a sales_orders_get, e ogni risorsa di terze parti che dichiari
la sua API diventa un insieme di strumenti senza lavoro aggiuntivo. Una chiamata passa dalla stessa
catena di un’analoga richiesta REST: espressioni di sicurezza, permessi del ruolo, ACL dell’admin, log
delle scritture e limiti di frequenza.
# i pacchetti del protocollo sono dipendenze opzionali,
# si installano solo quando MCP è acceso
composer require <pacchetti-mcp>
Per l’agente questo significa che il negozio non è un blocco monolitico: gli si può dare un ruolo con i soli permessi che servono, e le scritture restano tracciate nello stesso registro delle azioni umane.
Un negozio che si fa leggere
L’altra direzione è la visibilità. Qui nessuno scrive: un crawler legge, e la domanda è cosa gli lasci leggere e cosa vuoi che racconti. La configurazione sta in Catalog > Crawlers & robots.txt, con due gruppi, robots.txt e llms.txt.
Maho non serviva nessun robots.txt. Ora ne genera uno per dominio, con la logica di RFC 9309 applicata
come si deve: le regole di base vengono ripetute dentro ogni gruppo nominato, perché un gruppo
User-agent: GPTBot non eredita niente dal gruppo jolly, e senza ripetizione si finisce per esporre
tutto proprio al crawler che si voleva limitare. Le regole che nominano il percorso dell’admin vengono
scartate, così la strada del backend resta privata.
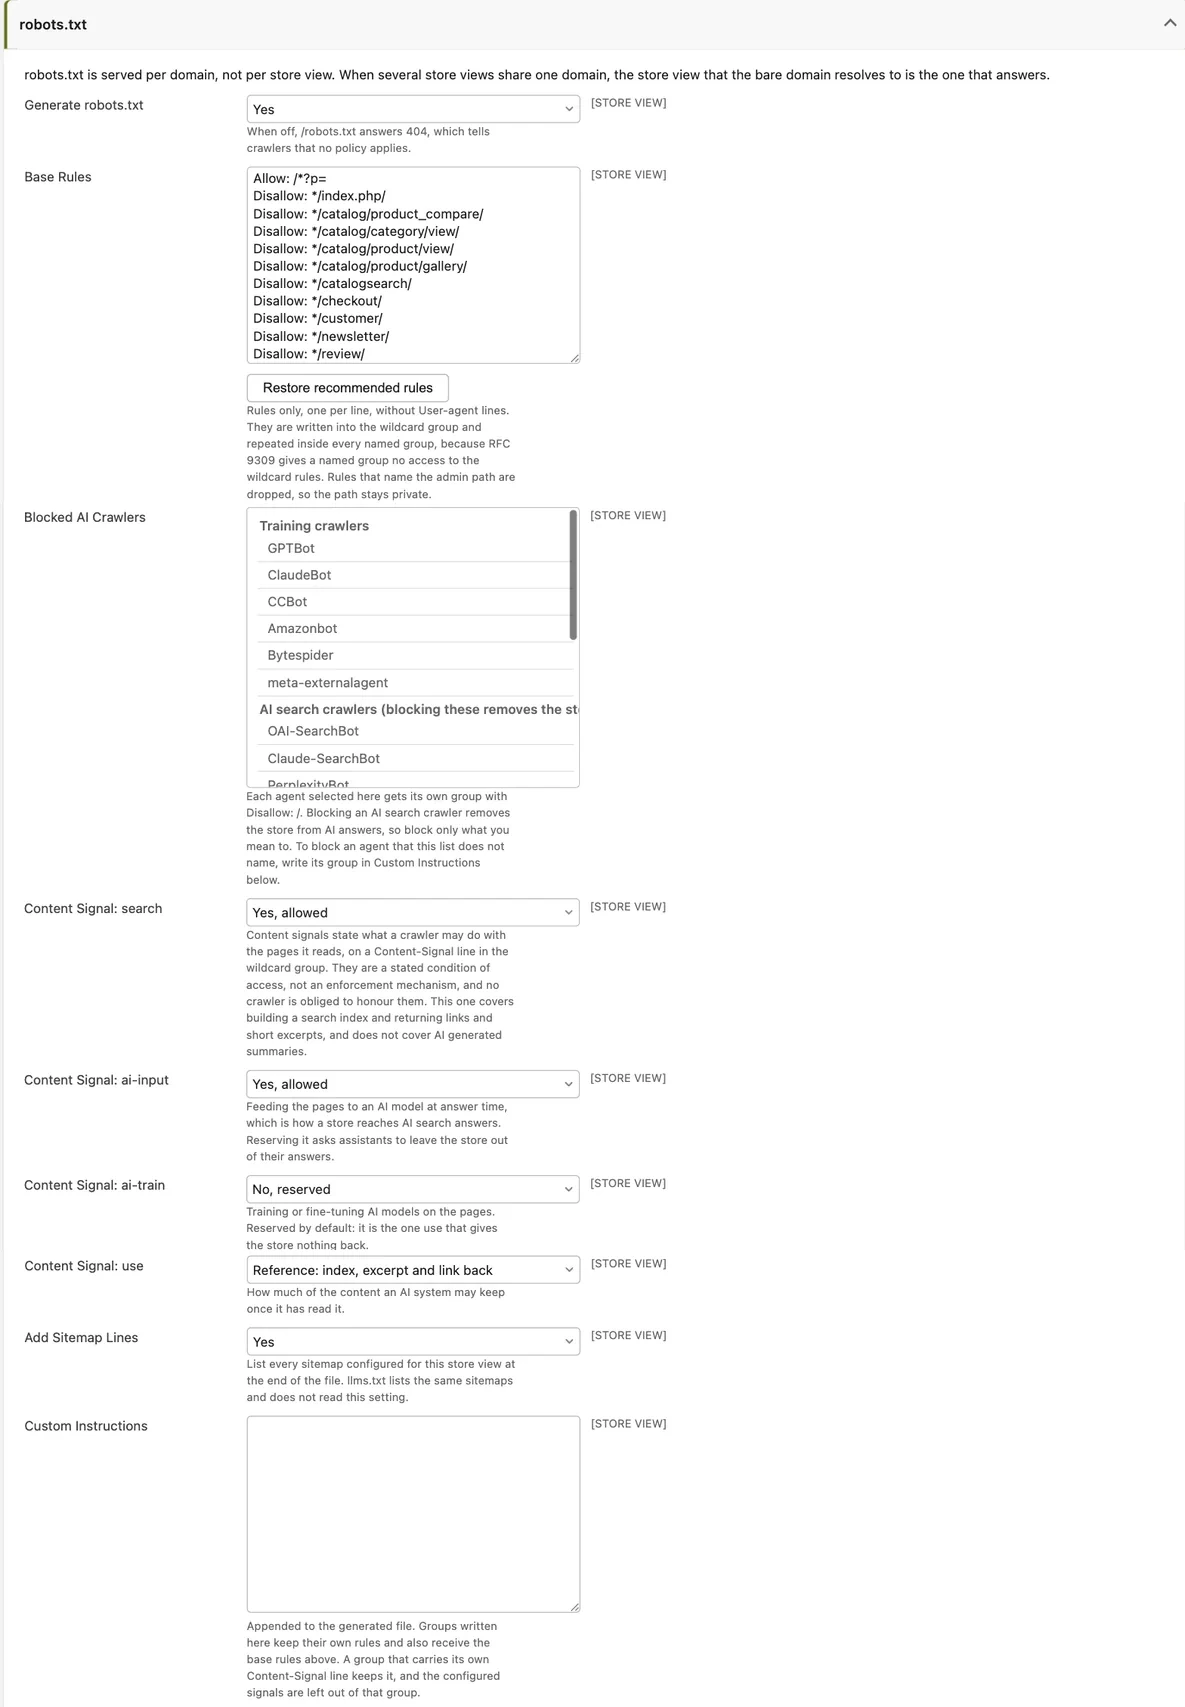
Le regole di base partono già con un elenco sensato, e un pulsante le riporta ai valori consigliati
quando qualcuno le ha modificate. Se invece disattivi la generazione, /robots.txt risponde 404 e i
crawler restano senza nessuna policy, che non è quasi mai quello che vuoi.
Nell’elenco degli agenti bloccati la scelta richiede attenzione, perché gli agenti sono raggruppati per
scopo: fermare i bot che addestrano modelli non toglie il negozio dalle risposte, fermare quelli di
ricerca AI sì. Accanto ci sono i Content Signals, quattro righe che dichiarano cosa un crawler può
fare con le pagine che legge: search, ai-input (il passaggio a un modello al momento della risposta,
cioè la strada per finire dentro una risposta AI), ai-train e use. Non sono un filtro tecnico, sono
una condizione dichiarata di accesso, e il default prudente è già impostato: ai-train riservato, perché
è l’unico uso che al negozio non restituisce nulla.
Poi c’è la parte che agli agenti serve davvero per capire: llms.txt come indice in markdown del
negozio, con nome, descrizione, locale, valuta, pagine CMS, post, categorie di primo livello, URL di
ricerca e sitemap, più un blocco markdown modificabile dall’admin, e llms-full.txt quando serve il testo
completo.
Il markdown è il pezzo che fa citare
Qui sta la parte che pesa di più su GEO e AEO, cioè sulla probabilità che un assistente citi il negozio in una risposta. La ragione è semplice e vale la pena dirla senza giri di parole: quando un agente legge una pagina prodotto in HTML paga la navigazione, gli script, gli stili e il codice di tracciamento prima di arrivare al prezzo, e quel costo lo porta via in token. La maggior parte del budget se ne va in rumore, e alla fine l’agente deve ancora indovinare quale pezzo della pagina sia il prezzo.
Dalla 26.9 lo stesso URL risponde in markdown quando l’agente lo chiede. Basta l’header
Accept: text/markdown, che è quello che manda Claude Code per default, oppure .md in fondo al
percorso: /women/ diventa /women.md e lafayette-dress.html diventa lafayette-dress.html.md. La
risposta è lo stesso documento per entrambe le strade, e browser e motori di ricerca continuano a
ricevere la pagina HTML di sempre.
Il markdown non è una copia della pagina, è la pagina riscritta per un lettore che vuole fatti:
- un prodotto porta nome, SKU, prezzo (con il prezzo pieno quando c’è uno sconto), disponibilità, marca, GTIN, URL delle immagini, descrizione, gli attributi della scheda e una riga per ogni opzione di un configurabile o di un raggruppato, con il suo prezzo e la sua disponibilità;
- una categoria porta la descrizione e i primi cento prodotti in tabella con link, SKU, prezzo e disponibilità, e per il resto rimanda alla sitemap XML;
- pagine CMS e post del blog portano titolo e contenuto convertito in markdown, con le direttive del template risolte.
Perché questo migliora le citazioni: una tabella di prodotti con SKU, prezzo e disponibilità è una
risposta già pronta, e un assistente che trova la risposta pronta la cita molto più volentieri di uno che
deve ricostruirla da un albero di div. Meno ambiguità significa meno errori nel riportare il prezzo, e
un prezzo riportato correttamente è la differenza fra una citazione utile e una che il cliente scopre
sbagliata al checkout.
Ogni pagina HTML annuncia la sua versione markdown con un header Link: rel="alternate", la risposta
markdown è noindex così i motori non vedono un doppione, e l’output è in cache per store view e valuta.
Le pagine markdown sono attive per default su catalogo, CMS e blog, e si possono limitare per percorso o
spegnere dalla stessa sezione di configurazione.
⭐ Nota stellare: qui si vedono gli effetti di una cosa che sembra un dettaglio tecnico. Il markdown non cambia quello che il cliente vede sul sito: cambia quello che l’assistente riesce a raccontare del sito quando il cliente non c’è.
Dove le due direzioni si incontrano
La tentazione è pensare che basti una delle due, e le scorciatoie portano sempre nello stesso posto: dare
per scontato che un robots.txt protegga un’API, o pensare che un server MCP serva a farsi trovare dai
motori. Sono mestieri diversi: uno è un problema di autorizzazione, l’altro di pubblicazione.
Il punto di contatto è il contenuto. Un agente che compra ha bisogno di sapere cosa vende il negozio, quindi di titoli, attributi, disponibilità e immagini leggibili. Un assistente che cita ha bisogno degli stessi dati nella forma giusta. Un catalogo con descrizioni fatte di tre righe copiate dal fornitore non funziona in nessuno dei due casi, e nessuna configurazione lo salva.
⭐ Nota stellare: tutto questo discorso ruota attorno alla stessa cosa. L’AI non legge il tuo sito come lo legge una persona, e tutto quello che stai preparando qui è, di fatto, un catalogo ben scritto con l’etichetta giusta.
Cosa fare adesso
- Accendi MCP solo se hai un uso concreto, con un ruolo dedicato di permessi minimi.
- Guarda il robots.txt generato e verifica le regole di base prima di toccare l’elenco degli agenti.
- Scegli i Content Signals in base a cosa vuoi che l’AI faccia del tuo contenuto, non per riflesso.
- Apri le pagine markdown su catalogo, CMS e blog e controlla un prodotto con varianti.
- Leggi
llms.txtcome lo leggerebbe un agente: se l’elenco delle categorie non è quello che vuoi mostrare, sistemalo dall’admin.
Il resto lo fa il tempo: le risposte AI si costruiscono sull’indicizzazione che esiste e sulla fiducia che il negozio si guadagna, e nessuna delle due si compra con un interruttore.
Testo preparato con l'aiuto dell'AI e verificato sulla fonte prima della pubblicazione. Può contenere errori: se ne trovi uno, segnalalo.Leggi il Manifesto
Il tuo negozio vende ancora?
Raccontaci da dove parti: ti rispondiamo con una prima valutazione, senza impegno.
Chiedi l'analisi del negozio